AI 智能机器头一代是我基于小智开源项目二次开发的全栈项目。我参与了 Vue 前端、Java 业务后端开发,以及语音交互、微信接入和部署运维。项目把 ESP32 表情屏与机器头接入统一平台:设备负责采音、播放和动作,Python 负责实时对话,Java 负责身份、配置、设备关系和业务任务,Vue 前端提供管理配置与设备控制的操作界面。
这篇文章沿着“一句话怎样变成设备反馈”展开,再说明各个环节的优化。重点是处理流程、状态变化,以及可以从实现中核实的收益。
优化按时间、功能体验、工程效率与运维分类,注明业务、实现方式和效果。时间数据按日志观察与阶段核算分别展示。
1. 项目全貌:设备、语音服务和业务服务怎样协作
| 模块 | 技术与职责 |
|---|---|
| 管理台 | Vue 3、Element Plus、Vue Router、Vuex;管理智能体、模型、音色、设备与微信授权 |
| Java 业务服务 | Java 21、Spring Boot 3.4.3、MyBatis-Plus、Shiro、Liquibase;处理用户、租户、配置、提醒和业务记录 |
| Python 语音服务 | WebSocket、VAD、ASR、LLM、TTS;维护设备连接、工具调用和音频队列 |
| 数据与路由 | MySQL 持久化业务数据;Redis 缓存、连接映射与消息分发;对象存储保存音频等文件(云上 OSS,自托管 MinIO) |
| 设备端 | ESP32 采音、编解码与播放;表情显示及适配后的机器头动作 |
普通语音音频通过 WSS 直接进入 Python。Java 提供业务配置、身份与任务接口;数据库写入和音频上报在语音处理之外完成。知识库、记忆和工具按智能体配置启用。
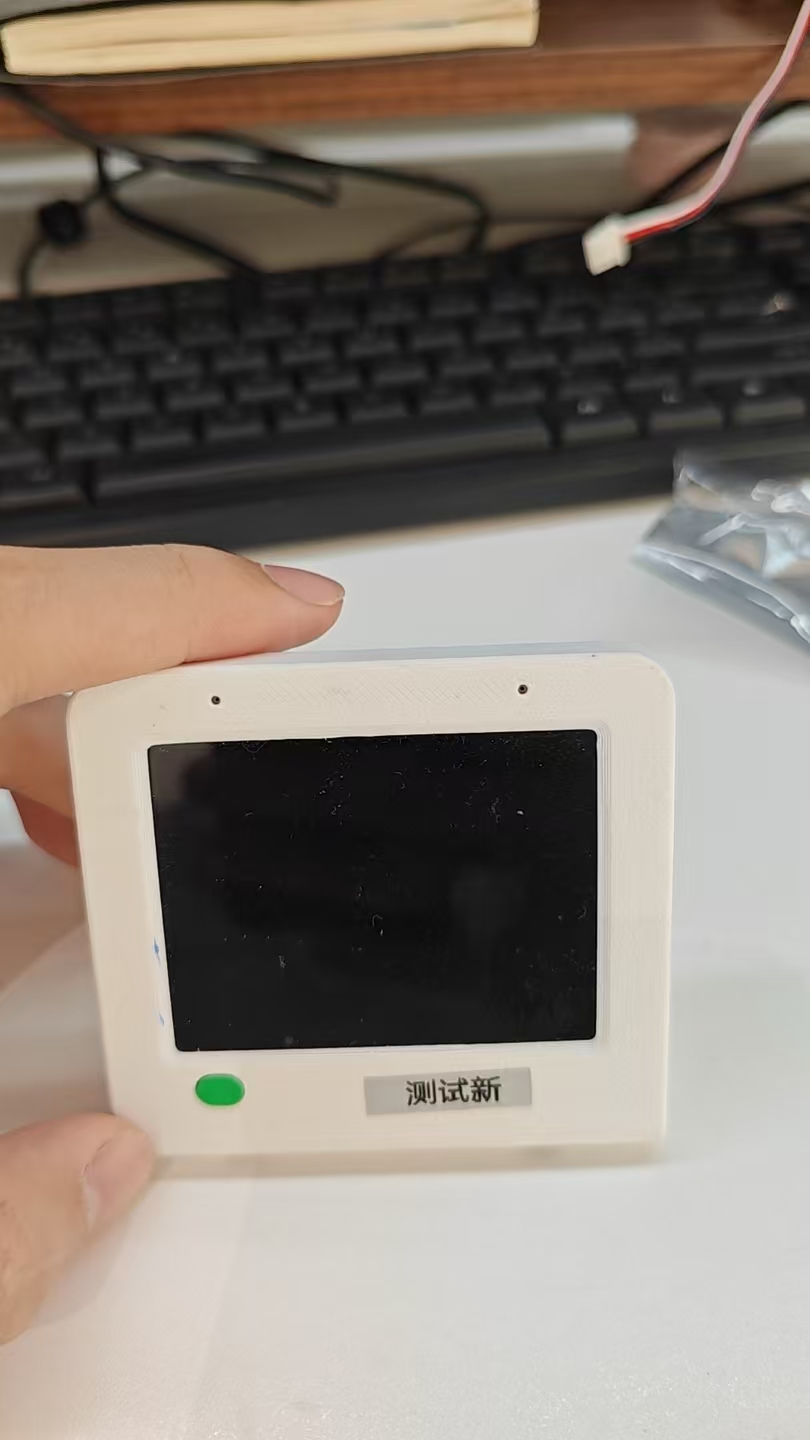
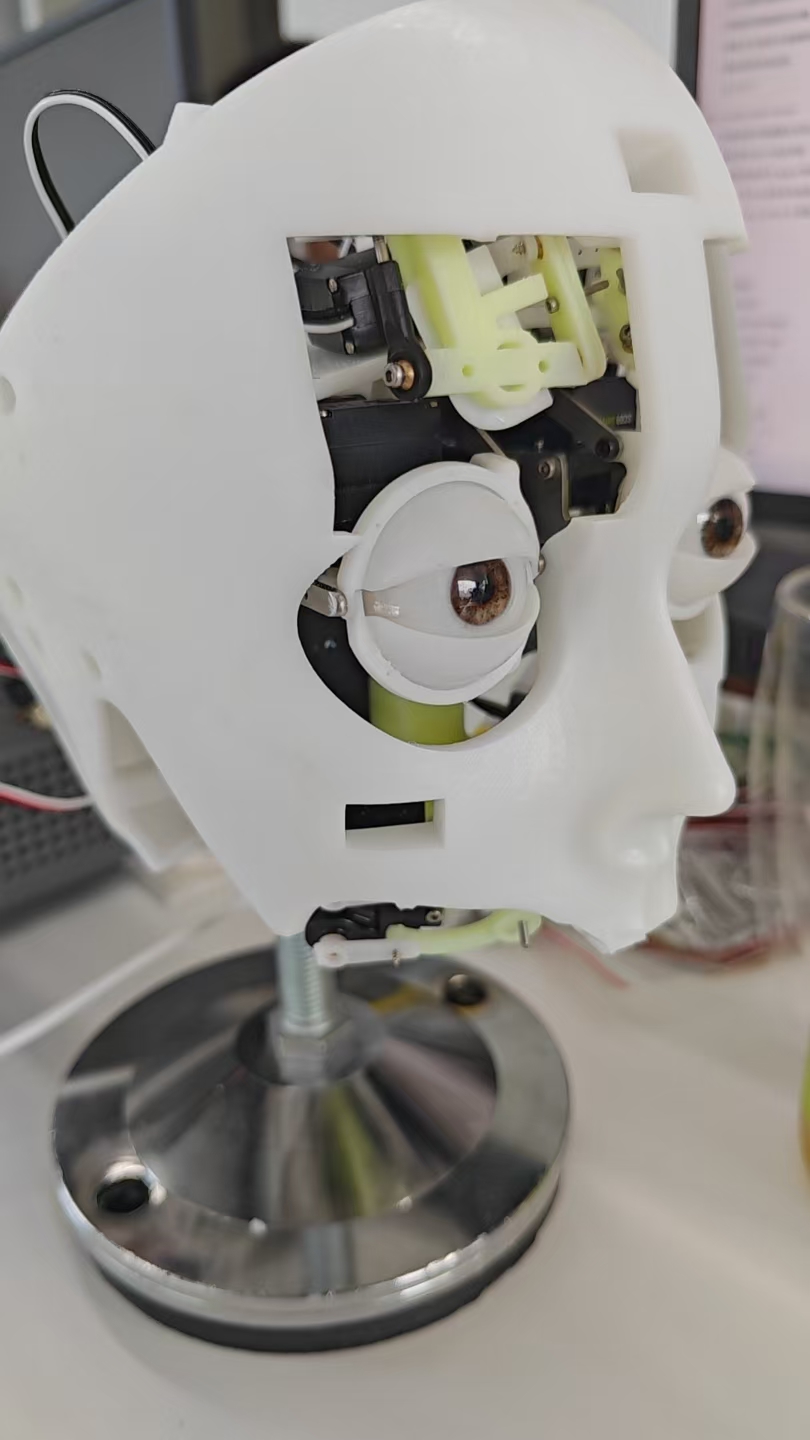
表情屏提供声音与视觉反馈,机器头执行固件支持的动作。动作范围取决于硬件结构、舵机和配置。我的工作重点是把开源语音底座与这些业务入口、控制链路和运维流程连接起来。
2. 设备接入:从 OTA、绑定到 WebSocket 会话
设备先通过 OTA 接口取得固件信息、连接地址及按配置提供的鉴权信息。未绑定设备通过激活流程建立用户、设备、智能体和租户关系。随后设备连接 Python,服务端创建 ConnectionHandler,从 Java 读取该设备的角色、模型、音色和工具配置。
hello 协商音频参数和设备能力;具备 MCP 能力的设备继续初始化工具列表。设备在线后,Redis 记录设备所属实例与连接标识,管理台的主动控制才能找到持有这条连接的 Python 实例。
身份分三层处理: 管理台用户使用服务端签发并校验的 Token;服务间请求使用管理配置中的共享凭证;设备 WebSocket 可按开关使用基于设备标识的 HMAC 鉴权。它们有不同的校验入口和生命周期。
3. 一轮对话主流程:声音怎样变成回答
- 采音上传。 用户唤醒或按键开始录音,设备将声音编码为 Opus 等约定格式,通过 WebSocket 上传二进制音频帧。
hello、listen、abort使用 JSON 文本消息。 - 消息分流。 Python 将文本交给控制处理器,将音频放入
asr_audio_queue,按顺序消费。连接配置和绑定状态决定后续路径。 - VAD 与 ASR。 VAD 判断是否有人说话及何时结束;ASR 生成识别文本。流式 ASR 逐帧发送,非流式 Provider 按完整语音片段处理。手动停止与自动静音判定分别触发结束流程。
- 业务分流。
startToChat检查额度、静默状态和明确指令。完整表情指令命中时直接发送控制;普通问答继续进入模型。 - 组织上下文。 将识别文本、系统提示、角色、历史以及按配置启用的记忆组成请求;开放工具时附带工具定义。
- 模型与工具。 流式接收模型回复;收到
tool_calls后,先拼完整参数,执行插件、MCP 或业务接口,再把结果关联到tool_call_id,交给模型继续回答。 - 分句合成。 文本进入 TTS 队列,按分段策略生成音频,再进入发送队列。后面的内容仍在生成时,前面的句子可以开始合成。
- 设备播放。 同一连接返回
stt、tts.start、分段文本和二进制音频。发送器按帧时长控制速度,设备解码播放并更新画面。 - 记录上报。 对话文本和音频异步上报到 Java,写入业务记录与对象存储。服务端的
tts.stop表达发送收尾,不等于设备已确认播完。
工具调用是怎样闭环的
Function Call 表达模型希望调用什么;MCP 提供能力发现和调用协议;程序负责参数校验、适配执行和结果回填。当前设备 MCP 默认等待超时为 30 秒 ,工具递归深度上限为 8 。它们是保护参数,不是响应时间承诺。当前仓库没有实现标准 Agent Skills 加载,文章只将已接入的插件和 MCP 列为现有能力。
4. 管理台、业务权限与 Redis 设备路由
我参与 Vue 管理台的前端开发,并与 Java 业务接口联调,完成智能体配置、设备绑定、主动播报和微信托管等操作。路由懒加载减少初始页面加载范围,请求层统一处理登录态、错误和超时。页面权限决定入口展示;接口仍需校验用户、租户及设备归属。
控制与提醒怎样找到设备
提醒插件请求 Java 创建持久化任务,到期后经 Redis Stream 投递给目标 Python 实例。管理台的播报、表情和静默切换也复用实例路由。实例消费消息后,找到本机连接并发送 WebSocket 控制。
| 路由参数 | 当前值 |
|---|---|
| 实例心跳间隔 / 存活 TTL | 10 秒 / 30 秒 |
| 设备映射刷新间隔 / TTL | 60 秒 / 3600 秒 |
| 定向控制消费方式 | 每实例 Stream,消费组读取后确认 |
5. 微信接入:授权、用户身份和小程序交付
微信侧有三条业务链:商户授权建立 AppID 与租户关系;用户临时 code 换取 openid,在对应租户内登录;模板经过体验、审核和发布形成小程序交付。微信业务没有绕过 Java 的身份与权限边界。
WxAppidTenantInterceptor 从 X-Wx-Appid 解析租户,在请求结束和异步交接时清理线程上下文。手机号绑定按租户检查冲突,当前实现会拒绝已被其他账户占用的号码。设备动作记录也区分普通用户、租户内授权用户和超管的数据范围。
6. 构建与部署流程
这个项目有阿里云和自托管两套交付环境。云上使用云效、ACR、Kubernetes 及托管数据服务;自托管环境使用 GitLab CI、Harbor、Helm。下面分别记录,方便排查时找到对应的入口和配置。
6.1 阿里云部署与网络访问
云上部署覆盖 容器运行、镜像仓库、CI/CD、数据库、缓存、对象存储、日志和网络出入口。这套部署运行在深圳地域的 ACS Kubernetes 集群 中。
入口:公网 ALB 接收 HTTPS / WSS 请求,Ingress 按域名分流到应用。 管理台和设备接入使用各自的域名。生产命名空间为 ai-server,测试环境为 ai-server-test;应用 Service 使用 ClusterIP。
| 访问入口 / 服务 | 云上目标 | 作用 |
|---|---|---|
| 管理台入口 | manager-api · 8002 | 提供 Vue 管理台页面,连接 Java 业务接口 |
| 管理服务内部接口 | manager-api · 8003 | 配置、设备与业务 API;Python 通过 Service 地址访问 |
| 设备语音入口 | xiaozhi-server · 8000 | WebSocket 连接与实时语音会话 |
| 设备 HTTP 入口 | xiaozhi-server · 8003 | OTA、激活等设备接入请求 |
表中端口是应用 / Service 端口。公网用户通过 ALB 的域名与监听端口访问;图中的 Ingress → Service / Pod 表示逻辑路由关系。
内网:服务发现、数据访问和文件存储各有对应路径。 集群中的服务通过 Service DNS / ClusterIP 通信,业务数据存入云数据库 RDS MySQL,云 Redis 承担缓存、设备路由与消息协作。云 Redis 与集群处于同一 VPC,部署清单使用私网连接地址;OSS 使用深圳地域的 internal Endpoint,ACR 拉取地址也使用 VPC 域名。
RDS、Redis、OSS、ACR 和 SLS 由云服务提供,Kubernetes 中运行的是业务应用。排查连接问题时,分别检查 Service 发现、私网连接地址和云服务 Endpoint。
出网:集群主动访问公网 API 时,经公网 NAT 网关做 SNAT。 两个交换机均配置了 SNAT,并使用同一个 EIP;默认路由指向该 NAT 网关。外部 LLM、ASR、TTS 和微信接口等公网请求走这条路径。ALB 负责业务入站,NAT 负责主动出网,二者分工明确。
日志:Java 与 Python 的标准输出接入 SLS。 生产清单分别配置应用 Logstore 与服务标签,排查时可以把请求日志、容器状态和镜像版本对应起来。例如深度思考开关未生效的问题,就是结合模型请求日志定位配置传递环节。
6.2 云效 CI/CD 与镜像交付
云效中分别维护 Java、Python 的生产与测试流水线。生产流水线由 Codeup 仓库的合并请求 触发,Java 的成功记录包含“构建 Docker 镜像并推送镜像仓库”和“发布”两个阶段;运行中的 Java、Python 镜像标签与对应流水线的提交和构建序号一致。
manager 镜像承载 Vue 管理台、Java 后端及 Nginx,语音服务独立构建 Python 镜像。流水线构建后推送 ACR,部署阶段更新目标命名空间的应用,集群从 ACR 的 VPC 地址拉取镜像。按服务、分支、提交和构建序号组织标签,可以追踪“这次发布到底运行了哪份代码”。
环境配置包括数据库、Redis、OSS 和管理服务连接参数;生产与测试使用各自的发布清单和命名空间,分别维护配置并执行发布。
本文的 GitLab 源码仓库 提供云部署文件参考:manager 清单、语音服务清单。云效以 Codeup 为流水线输入,云上运行版本以流水线记录和已部署镜像为准。
6.3 自托管交付环境
自托管流程由 .gitlab-ci.yml 引入 ci/csghome/pipeline.yml。manager 与 Python 语音服务分别构建镜像并推送 Harbor,再通过 Helm 发布到 Kubernetes。前端静态文件、Java JAR 和 Nginx 装入 manager 镜像。
此前核对的自托管 xiaozhi 命名空间中,manager 与语音服务各 1 个副本,HPA 未启用;入口使用 Traefik,证书由 cert-manager 管理。这套入口和发布链路与上面的阿里云环境分别维护。
网络机制参考:公网 NAT 与 SNAT、OSS 地域与内网 Endpoint。图示按 2026 年 10 月的核对结果整理,省略账号、实例 ID、实际 IP 和业务域名。
7. 项目优化与效果
优化分为时间优化、功能与体验优化、工程效率与运维优化。时间优化列出处理前后耗时、减少的等待和计算口径;功能与工程优化说明具体业务收益。
7.1 语音响应时间优化
“首音频总等待”指从该请求的日志起点到服务端发出首个音频包,衡量多久开始返回语音。LLM 响应、工具返回后的处理和整条请求分别计时,避免把阶段收益重复相加。
7.1.1 语音短答:移除生成后的二次压缩与改写
优化方法: 原方案在主模型生成回答后,再请求模型将回答缩成一句,压缩完成才交给 TTS。现在直接使用主模型的完整首句,省去额外压缩和重复话术改写的等待。
整体效果: 两条原请求分别可以减少 3.03 秒和 5.67 秒的串行压缩等待。
| 原日志样本 | 原总等待(实测) | 移除的压缩耗时 | 优化后总等待(推算) | 总等待降幅 |
|---|---|---|---|---|
| 语音请求 | 7.86 秒 | 3.03 秒 | 4.82 秒 | 38.6% |
| 文本请求 | 9.79 秒 | 5.67 秒 | 4.12 秒 | 57.9% |
两条请求各执行过一次压缩。推算按“原总等待 − 压缩耗时”,假设其他阶段不变;重复改写没有单独计时,不额外叠加收益。
7.1.2 故事等长回复:LLM 生成与 TTS 合成并行
优化方法: 将“等全文生成完再合成”改为“生成一段、合成一段”。前段文字进入 TTS 时,LLM 继续生成后续内容。
整体效果: 两条长回复样本的首音频都在 1.55 秒左右发出。按同轮合成耗时不变计算,串行处理需要 2.70 秒,流式处理减少 1.15 秒等待,总等待缩短 约 43%。
| 长回复样本 | 串行总等待(推算) | 流式总等待(实测) | 减少等待 | 降幅 |
|---|---|---|---|---|
| 样本 A | 2.70 秒 | 1.55 秒 | 1.16 秒 | 42.8% |
| 样本 B | 2.70 秒 | 1.55 秒 | 1.15 秒 | 42.7% |
样本从文本请求开始计时,不含 VAD/ASR;实测首音频分别比 LLM 生成完成早 0.53 秒和 0.63 秒,说明生成与合成已并行。串行对照来自时间线推算,数值按原始毫秒计算后取整。
7.1.3 普通语音问答:通过阿里云日志关闭不必要的深度思考
定位过程: 在阿里云日志中观察到,普通问题的 LLM 响应耗时超过 2 秒,实际请求仍在使用深度思考。虽然管理配置已选择不启用思考,但传入的参数没有生效,模型继续执行了额外推理。
优化方法: 对照模型实际请求和响应日志校验参数,在请求中显式传入布尔 enable_thinking=false,使普通问答直接生成回答,省去不需要的深度思考过程。
日志观察:LLM 响应从 2 秒以上降到 0.8 秒,减少至少 1.2 秒,响应耗时下降超过 60%。
| 观察指标 | 调整前 | 调整后 | 改善 |
|---|---|---|---|
| 普通问答的 LLM 响应 | 超过 2 秒 | 0.8 秒 | 至少减少 1.2 秒,下降超过 60% |
这里记录的是阿里云排查中的模型阶段观察,未包含 VAD、ASR 和 TTS,不能作为整条语音请求的总耗时降幅。
7.1.4 语音判停:缩短说完话后的静音等待
优化方法: 将 VAD 静音窗口从 700 ms 调到 500 ms,让用户说完话后更快进入回答阶段。全模块参数通过 data/.config.yaml → manager-api 生效。
阶段效果: 历史日志中的判停均值由 0.72 秒降至 0.53 秒,少等待 0.19 秒,下降 26.5%。
整条链路观察: 同期判停与模型参数调整后,一组历史样本的首音频总等待由 3.14 秒降至 2.59 秒,减少 0.55 秒,下降 17.4%。
前后分别为 3 轮、4 轮;后组包含 3 条停止确认,设备和语料不同。这一整体变化由多个阶段共同形成,不能全部归因于 VAD,也不与上一节的模型日志观察叠加。
实现依据:旧版压缩策略、短答处理策略、当前聊天处理、模型请求参数。
7.2 设备指令与工具回复:减少中间等待
阶段核算口径: 7.2.1 与 7.2.2 移除步骤的收益统一按一次 LLM 0.8 秒、一次 TTS 0.6 秒作为参考基准,计算被省去的串行等待。它们属于阶段耗时核算,并非同一请求优化前后的实测总时长;识别、网络、工具执行和设备动作本身的耗时另计。
7.2.1 设备表情控制:明确指令直接下发动作
优化方法: 对“做某个表情”等完整指令进行本地匹配,命中后直接下发动作。动作映射保存在连接内,后续复用,避免反复读取 Redis。
等待收益: 省去模型组织回答和语音合成,按统一基准减少 0.8 + 0.6 = 1.4 秒的中间处理等待。动作可以在指令识别完成后直接发送,无需先等待一段语音回答。
7.2.2 设备工具执行:明确结果直接转语音回复
优化方法: 关机等工具已经返回可直接使用的结果时,立即交给 TTS;需要解释或继续组织答案的 REQLLM 结果再进入模型。
等待收益: 从工具返回开始,原本“模型组织答案 + TTS”的 1.4 秒准备过程,改为仅进行 TTS 的 0.6 秒,减少 0.8 秒,回复准备耗时下降 57.1%。以上按统一阶段基准核算,完整请求仍包含前面的模型决策和工具执行。
已有直接回复的关机日志中,整条请求到首音频为 2.29 秒,验证了这条路径已实际运行;该实测值与上面的阶段核算分别使用。
7.2.3 模型工具选择:精简 Function Call 与 MCP 工具定义
优化方法: 在语音交互配置中移除大部分不需要的 Function Call 与 MCP 工具,只向模型保留少量必要的 Function Call。搜索、提醒等业务工具改为按配置加载,车票查询等工具不再强制加载;明确表情指令交给本地匹配。
为什么更快: 每个工具都会携带名称、用途说明和参数定义。精简工具列表后,每轮模型请求附带的文本更少,模型需要读取和比较的候选方法也更少,因此可以缩短回答或选择工具前的等待。
时间收益(参考): 模型响应等待可减少 0.3–0.5 秒。该数值用于说明工具精简的预期收益,尚未通过同题前后对照日志单独验证,也不与关闭深度思考的收益直接相加。
实现依据:工具按需加载与表情指令本地化。这里精简的是当前场景提供给模型的工具列表,MCP 接入能力仍可按业务需要保留。
7.3 功能与体验优化
| 具体优化名称 | 实现方式 | 用户体验 |
|---|---|---|
| 普通语音问答:简短回答与长内容分流 | 简单问题使用完整首句,故事和详细解释允许连续生成 | 日常问答更简洁,需要长内容时可以继续展开 |
| 设备静默模式:暂停普通对话并保留管理控制 | Java 保存静默设置,在线设备实时切换,重连时重新读取 | 用户可暂停对话,管理台仍可控制设备 |
| 管理台登录会话:临近过期自动续期 | 登录凭证剩余不超过 2 小时时续期,并设置 5 分钟续期冷却 | 持续使用管理台时减少重新登录,并发接口请求避免反复更新有效期 |
这里的登录凭证用于用户登录管理台后访问设备列表、智能体配置等 Java 业务接口。成功续期后,有效期延长至当前时间后的 12 小时。
7.4 工程效率与运维优化
7.4.1 管理台登录校验:Redis 缓存登录凭证
Java 接口先从 Redis 获取登录凭证,未命中才查数据库并按剩余有效期回填,退出登录时清理缓存。缓存命中后省去令牌表查询,降低数据库访问压力;用户资料仍按接口需要查询。
7.4.2 管理台设备详情:按需获取在线状态
查看一台设备时,详情接口只读取目标设备及权限信息,在线状态交给专用接口按需查询。这样不必为单台设备拉取全量在线列表,减少随在线设备规模增长的额外工作。
7.4.3 微信商户授权:凭证持久化与缓存恢复
Refresh Token 同时保存在数据库,Redis 提供在线读取。缓存缺失时,从数据库恢复仍有效的凭证,再按需刷新,减少对重新授权的依赖。
7.4.4 CI 镜像构建与服务上线:复用依赖并保证发布顺序
BuildKit 复用依赖缓存,当前 CPU 环境使用 CPU 版 PyTorch。镜像按提交标识,先等待 manager 就绪并完成数据库迁移,再发布语音服务。缓存命中时跳过重复构建,上线时业务服务和数据库结构已提前就绪。
7.4.5 语音服务日志:分阶段计时与按设备关联
通过 log.response_latency_enabled 开启阶段计时,以 trace_id、sentence_id 关联同轮请求,区分 VAD、ASR、LLM、TTS 与发送等待。日志按日期落盘、保留 30 天并带设备关联信息,为参数调整和瓶颈定位提供依据。关闭深度思考就是由云端日志观察推动的一项优化。
7.5 按目标分类的优化汇总
7.5.1 时间优化:缩短语音、动作与工具回复等待
| 具体优化名称 | 前后耗时与改善 | 数据口径 |
|---|---|---|
| 语音短答:移除额外回答压缩 | 总等待 7.86 → 4.82 秒,少 3.03 秒、下降 38.6%;另一请求 9.79 → 4.12 秒,少 5.67 秒、下降 57.9% | 原日志扣除压缩耗时推算,其他阶段不变 |
| 长回复:LLM 生成与 TTS 合成并行 | 总等待 2.70 → 1.55 秒,少 1.15 秒、下降约 43% | 串行为同轮推算,流式结果为实测 |
| 普通问答:关闭不必要的深度思考 | LLM 响应 超过 2 秒 → 0.8 秒,至少少 1.2 秒、下降超过 60% | 阿里云日志排查中的模型阶段观察 |
| 语音判停:静音窗口缩短 | 判停 0.72 → 0.53 秒,少 0.19 秒、下降 26.5%;同期综合调整样本总等待 3.14 → 2.59 秒,少 0.55 秒、下降 17.4% | 历史样本观察,整体变化不单独归因于 VAD |
| 表情动作:明确指令本地直达 | 省去 LLM 与 TTS 串行处理,减少 1.4 秒中间等待 | 按 LLM 0.8 秒、TTS 0.6 秒的参考基准核算 |
| 设备工具:明确结果直接转语音 | 工具返回后的准备 1.4 → 0.6 秒,少 0.8 秒、下降 57.1% | 按统一阶段基准核算,前置决策与工具执行另计 |
| 模型工具选择:精简 Function Call 与 MCP 定义 | 减少工具说明和候选方法,模型响应等待可少 0.3–0.5 秒 | 参考收益,待同题对照日志验证 |
7.5.2 功能优化:改善对话与管理台使用体验
| 具体优化名称 | 使用效果 |
|---|---|
| 普通问答与长内容分流 | 日常回答简短,故事、解释可以持续展开 |
| 设备静默模式 | 暂停普通问答,保留管理控制,设置在重连后继续生效 |
| 管理台登录自动续期 | 持续使用时自动延长登录有效期,减少重新登录 |
7.5.3 工程效率与运维优化
| 具体优化名称 | 工程效果 |
|---|---|
| 管理台登录凭证缓存 | 命中 Redis 后省去令牌表查询,减少数据库访问压力 |
| 管理台设备详情按需查询 | 移除单设备详情附带的全量在线设备查询 |
| 微信授权凭证持久化 | Redis 缺失后从数据库恢复仍有效的凭证 |
| CI 镜像依赖缓存 | 复用未变化的依赖层,减少重复构建 |
| 数据库迁移与服务顺序发布 | 业务服务和数据库准备好后,再启动语音服务 |
| 语音阶段日志与设备关联 | 定位实际等待环节,支持参数优化与效果复核 |
7.6 数据口径与效果验证
本文区分日志观察、同轮推算和统一阶段基准核算。阿里云的 2 秒以上 → 0.8 秒来自深度思考排查记录;用于移除步骤核算的 LLM 0.8 秒、TTS 0.6 秒是参考基准,不代表所有请求的固定耗时。
工具精简的 0.3–0.5 秒属于参考收益,尚无独立的同题对照记录。
总耗时降幅按“减少的时间 ÷ 原耗时”计算。前后比较需保持计时起点和终点一致;不同模型、语料与运行环境的样本分别使用,重叠阶段及不同优化的收益不重复相加。
8. 总结与源码依据
这次二次开发形成了一条清晰的处理链:设备上传声音,Python 完成实时推理和反馈,Java 保证业务关系与配置,Vue 前端提供配置与控制入口,Redis 将控制送到正确实例,微信和 CI/CD 扩展业务入口与交付方式。优化时,我先确定用户等待和重复工作的来源,再用运行日志与处理流程验证优化效果。
源码与文档依据
以下链接固定到本次核对的提交;仓库访问权限决定读者能否打开。